Jefatura de estudios, calidad o un tutor preguntan en lenguaje natural y reciben un resumen, la tabla y el SQL que se ejecutó. Cuatro capas independientes garantizan solo lectura: nadie modifica ni borra datos.
Scholarium deja que cualquier profesor consulte los datos académicos del centro en lenguaje natural y reciba, sin pasar por un técnico, un resumen en una frase, la tabla y el SQL que se ejecutó.
El objetivo es dar esa agilidad sin que una IA pueda tocar la base. Un pipeline Medallón con Apache Airflow y dbt construye un modelo en estrella en PostgreSQL, y un gateway FastAPI traduce la pregunta a SQL, la valida en cuatro capas y la ejecuta con permisos de solo lectura. La calidad se mide en CI con un golden set, no se promete.
Consultar los datos del centro presenta siempre las mismas barreras, y delegar el problema ciegamente a una IA introduce nuevos riesgos. Cada una es un problema que nuestra solución se encarga de resolver.
Las notas salen del sistema de gestión en un XML que solo un técnico sabe consultar; cada pregunta pasa por un intermediario.
Dejar que un modelo escriba SQL contra la base abre la puerta a borrar, filtrar o escalar más allá de una consulta de lectura.
Inventa columnas y literales ('Superior' en vez de 'GRADO SUPERIOR') y devuelve un resultado plausible pero falso con etiqueta de acierto.
Toda consulta al LLM gasta tokens y segundos; una reformulación de algo ya respondido pagaría dos veces.
Los datos entran como XML y acaban en una respuesta en lenguaje natural. Entre medias, capas desacopladas: Airflow orquesta por eventos (cada DAG arranca cuando el anterior publica su asset, sin cron encadenado), un único PostgreSQL sirve a todos pero con un rol distinto por consumidor, y el gateway de IA queda aislado detrás del backend. Cambiar una pieza no obliga a tocar las demás.
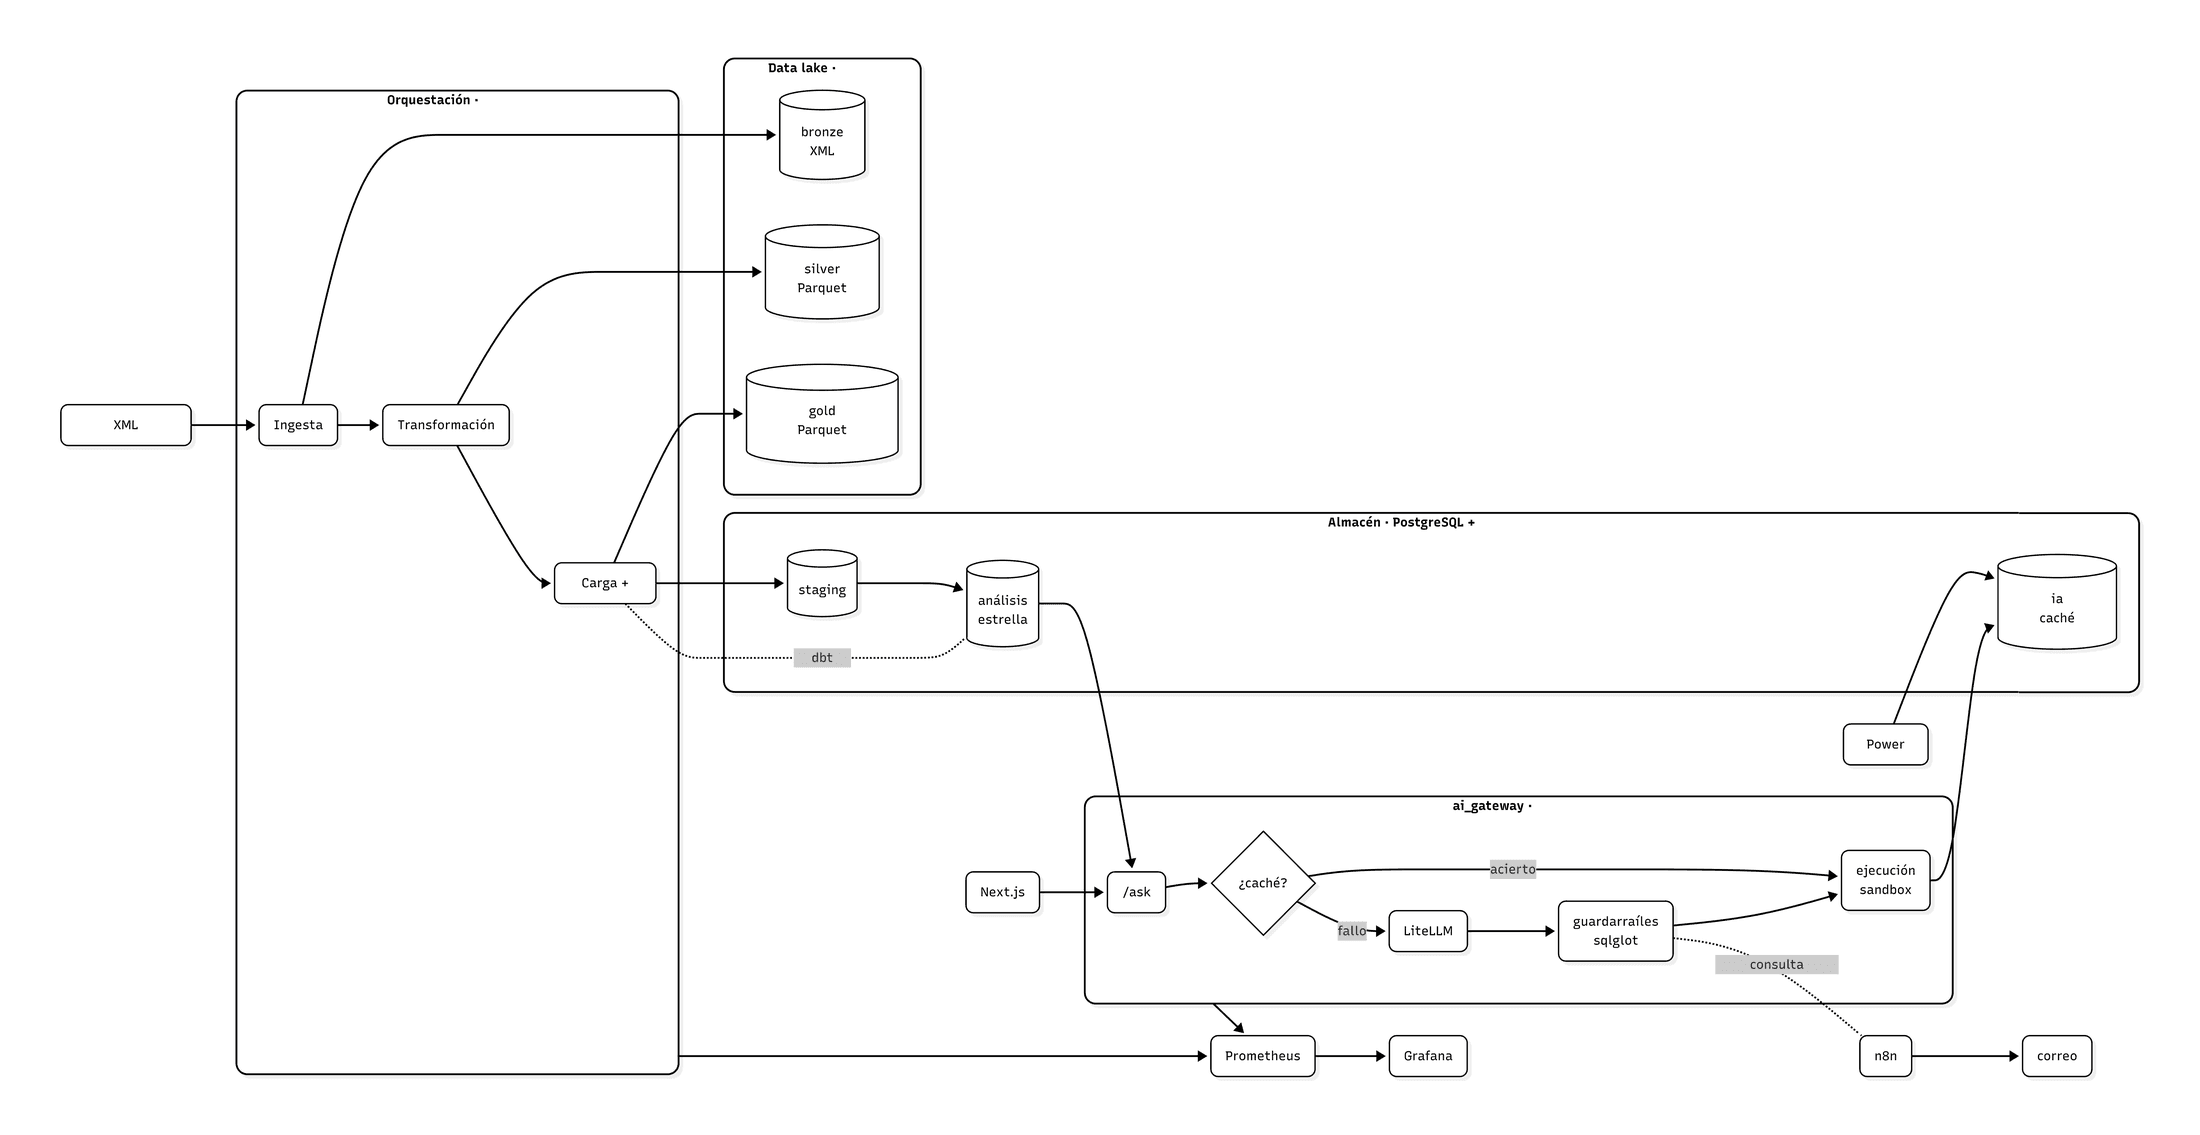
Tres DAGs de Airflow encadenados por eventos (cada uno arranca cuando el anterior publica su asset, no por cron) llevan los datos del XML crudo a un modelo en estrella. Los DAGs solo orquestan; la lógica vive en módulos aparte, que se testean sueltos.
Ingesta (bronze): valida el XML académico y lo deposita por año en un data lake compatible con S3 (MinIO).
Transformación (silver): limpia, anonimiza el NIA con SHA-256 y aplana la jerarquía académica a Parquet tipado.
Carga (gold): carga a staging, dbt build construye la estrella y la testea con 15 tests de datos, y exporta los marts.
Refresco: avisa al gateway de IA, que recarga su esquema e invalida la caché.
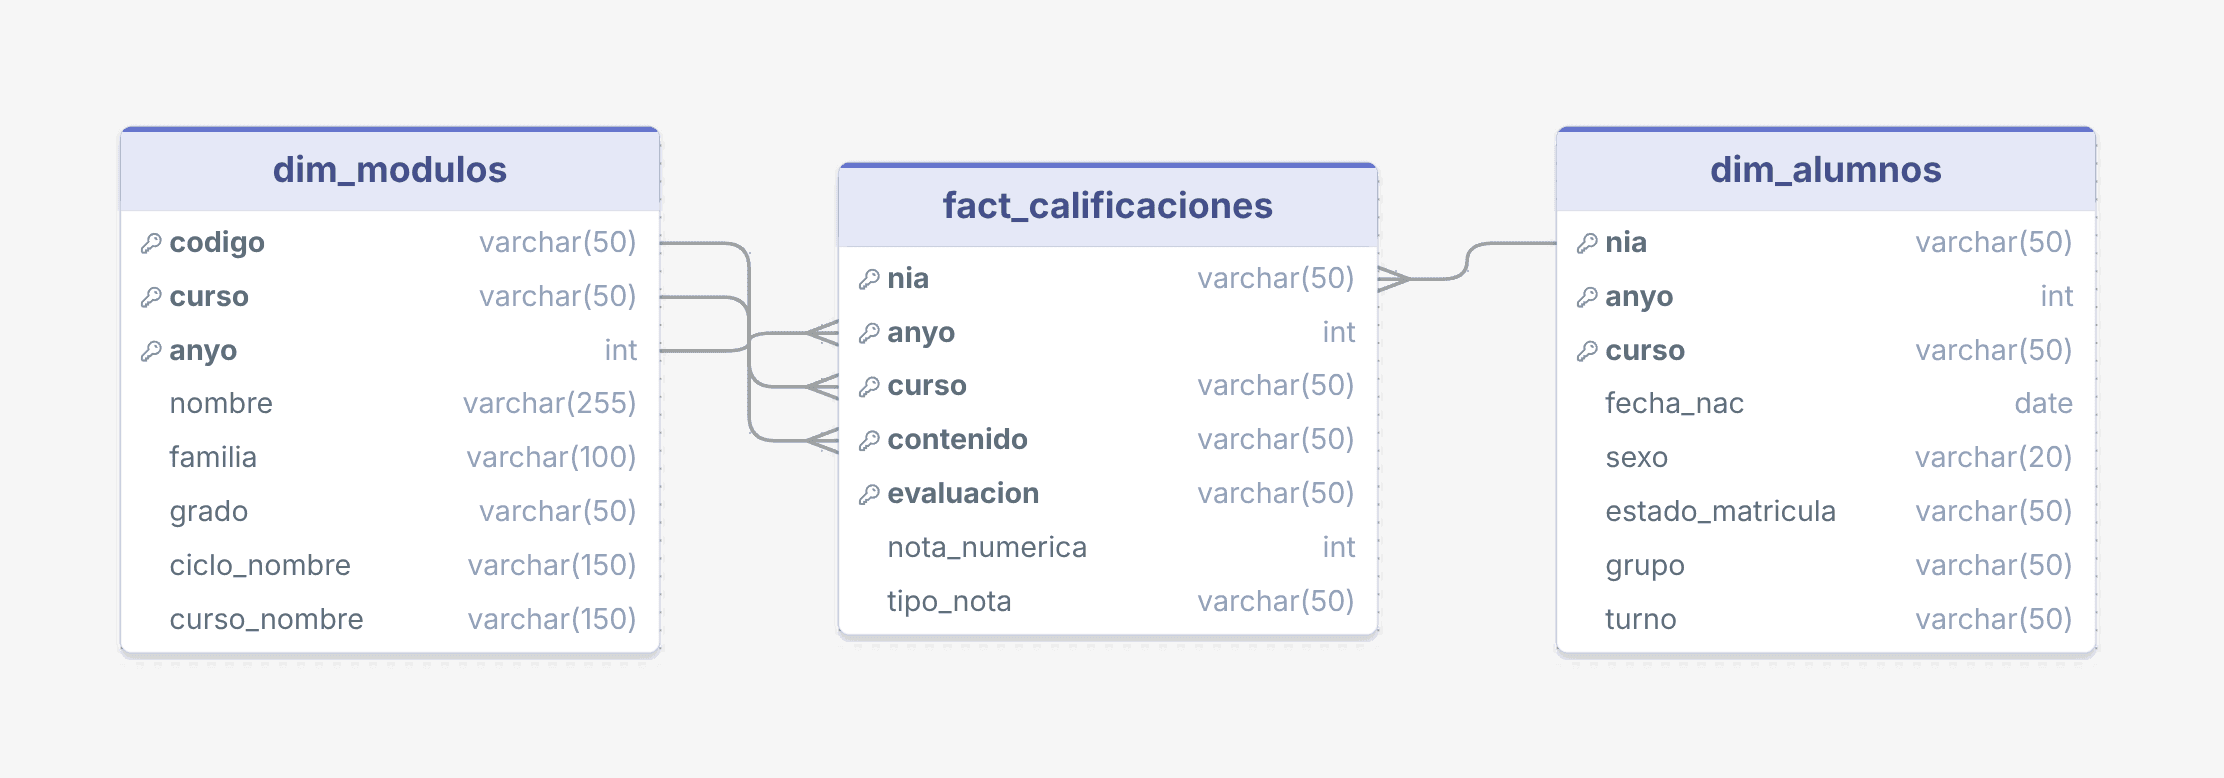
dbt materializa el staging en views (solo tipado y renombrado) y los marts en tablas. El modelo en estrella queda así:
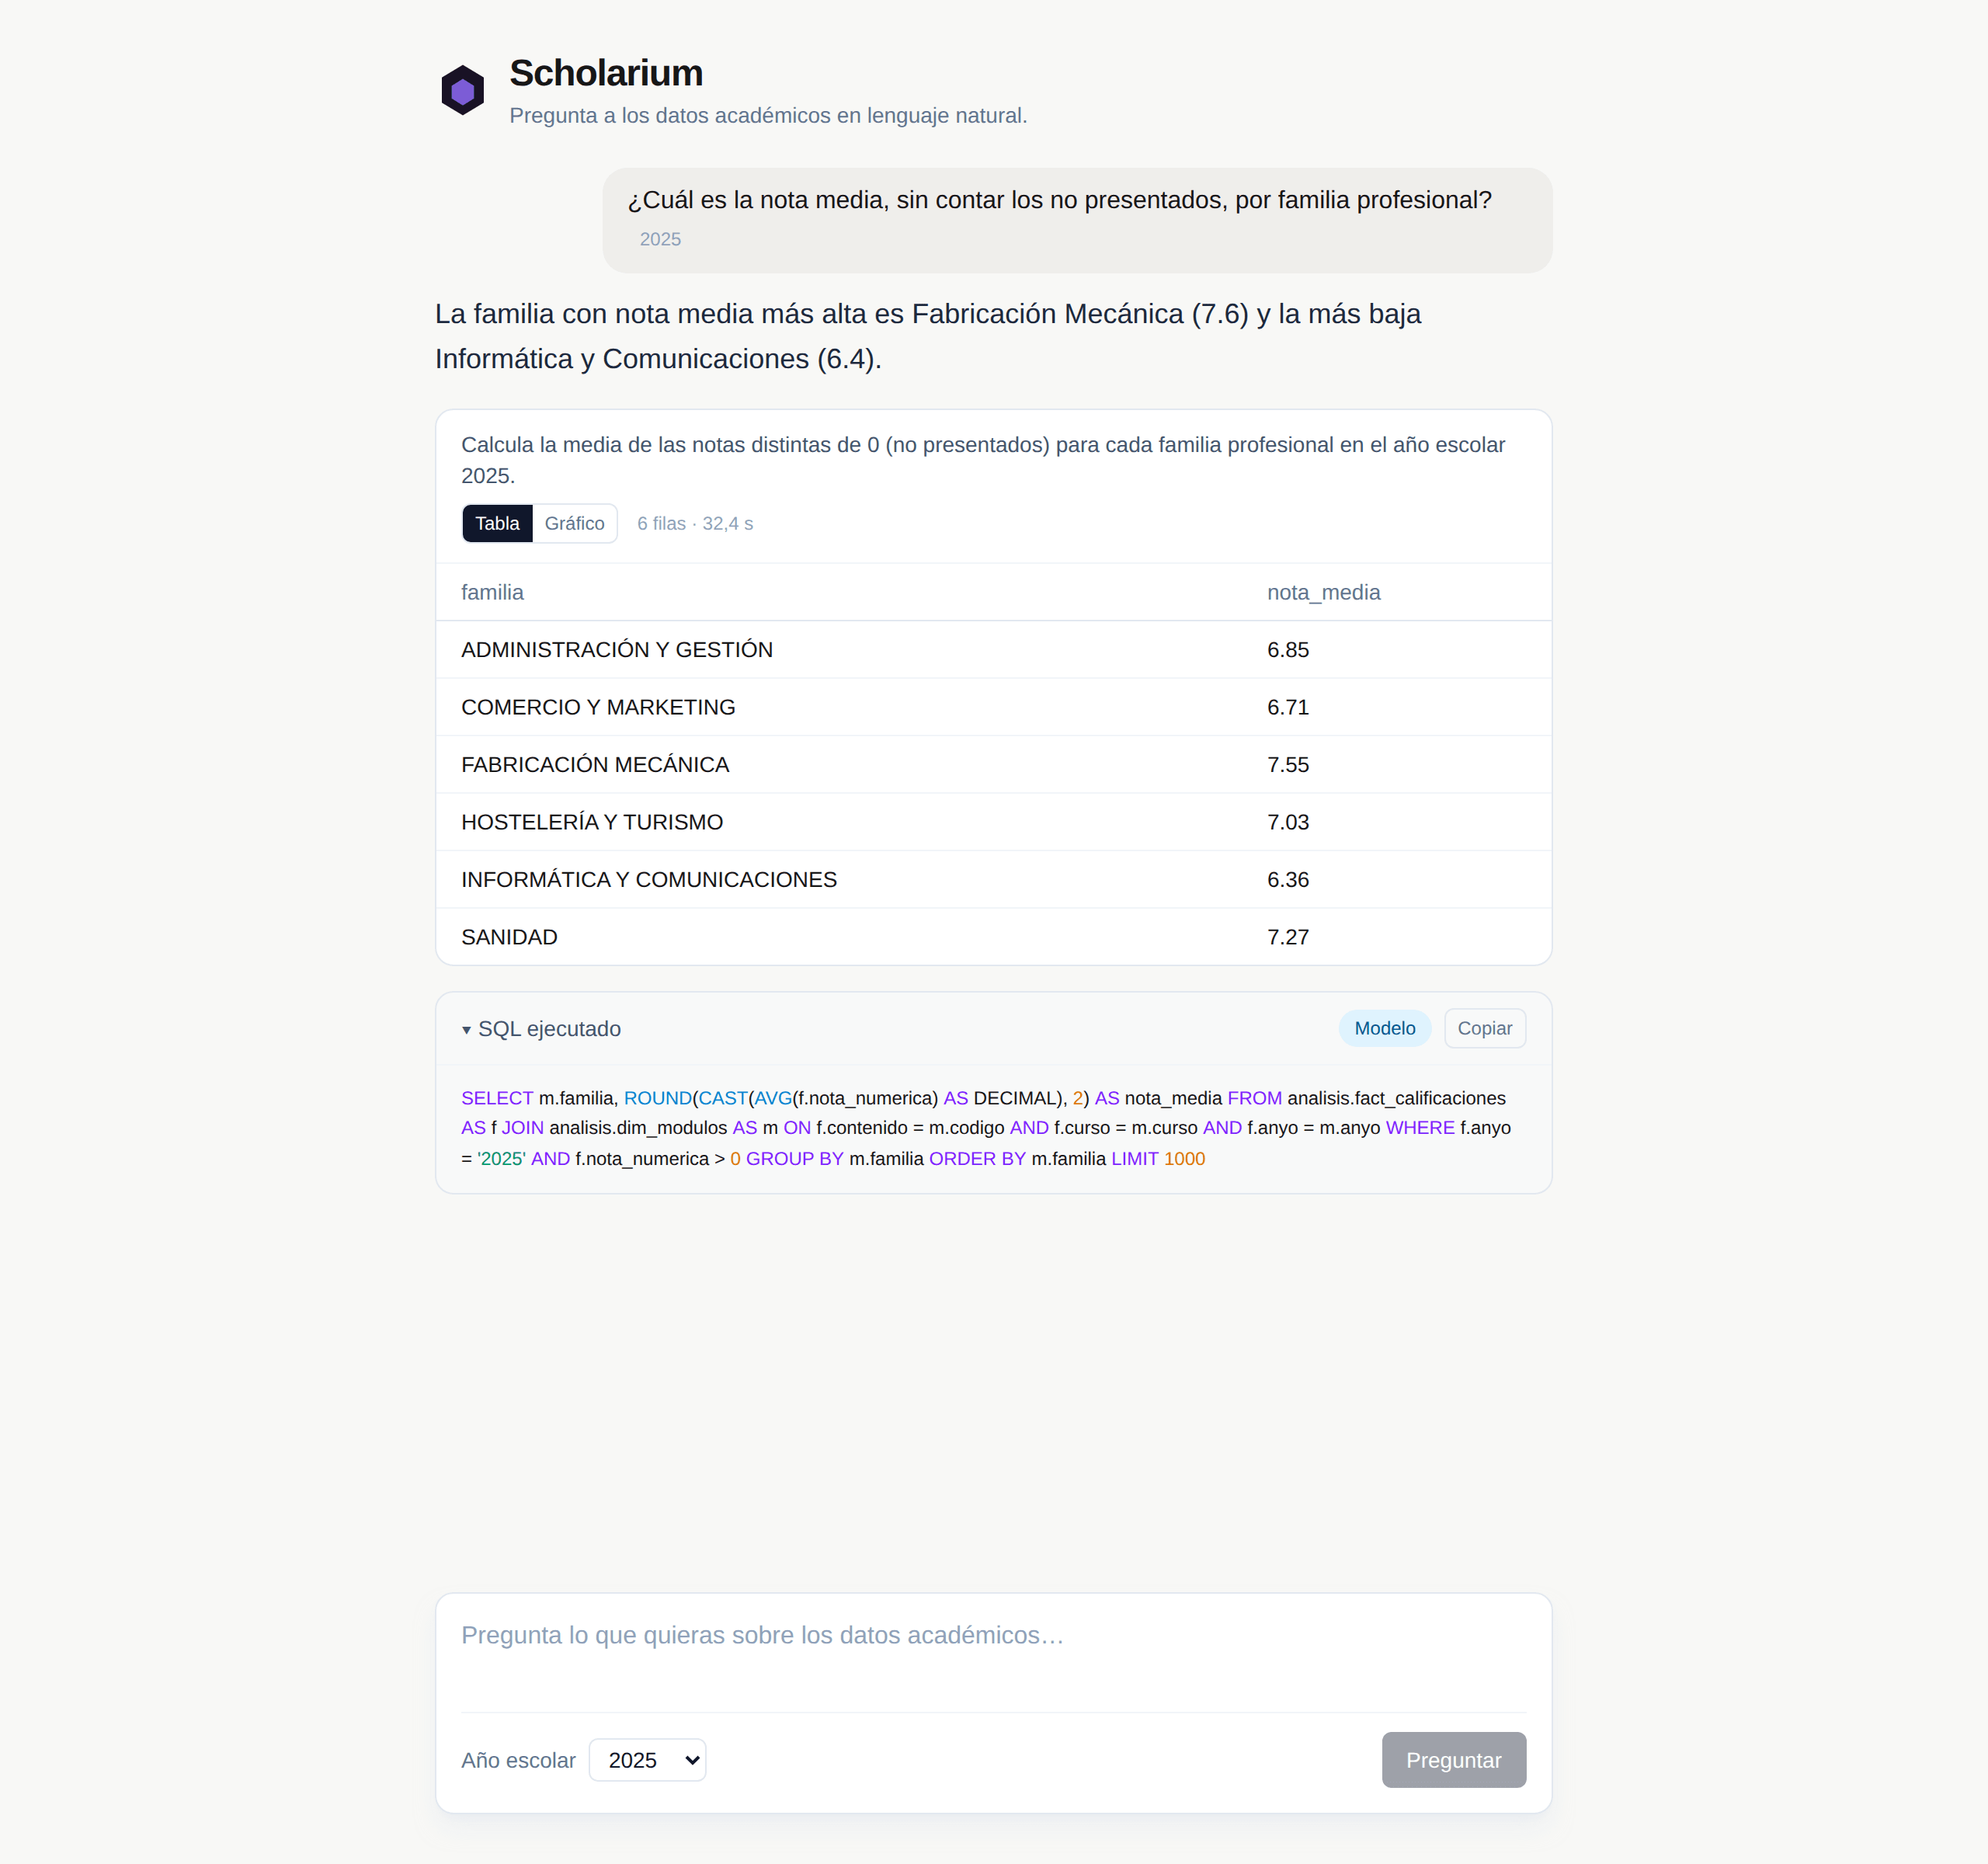
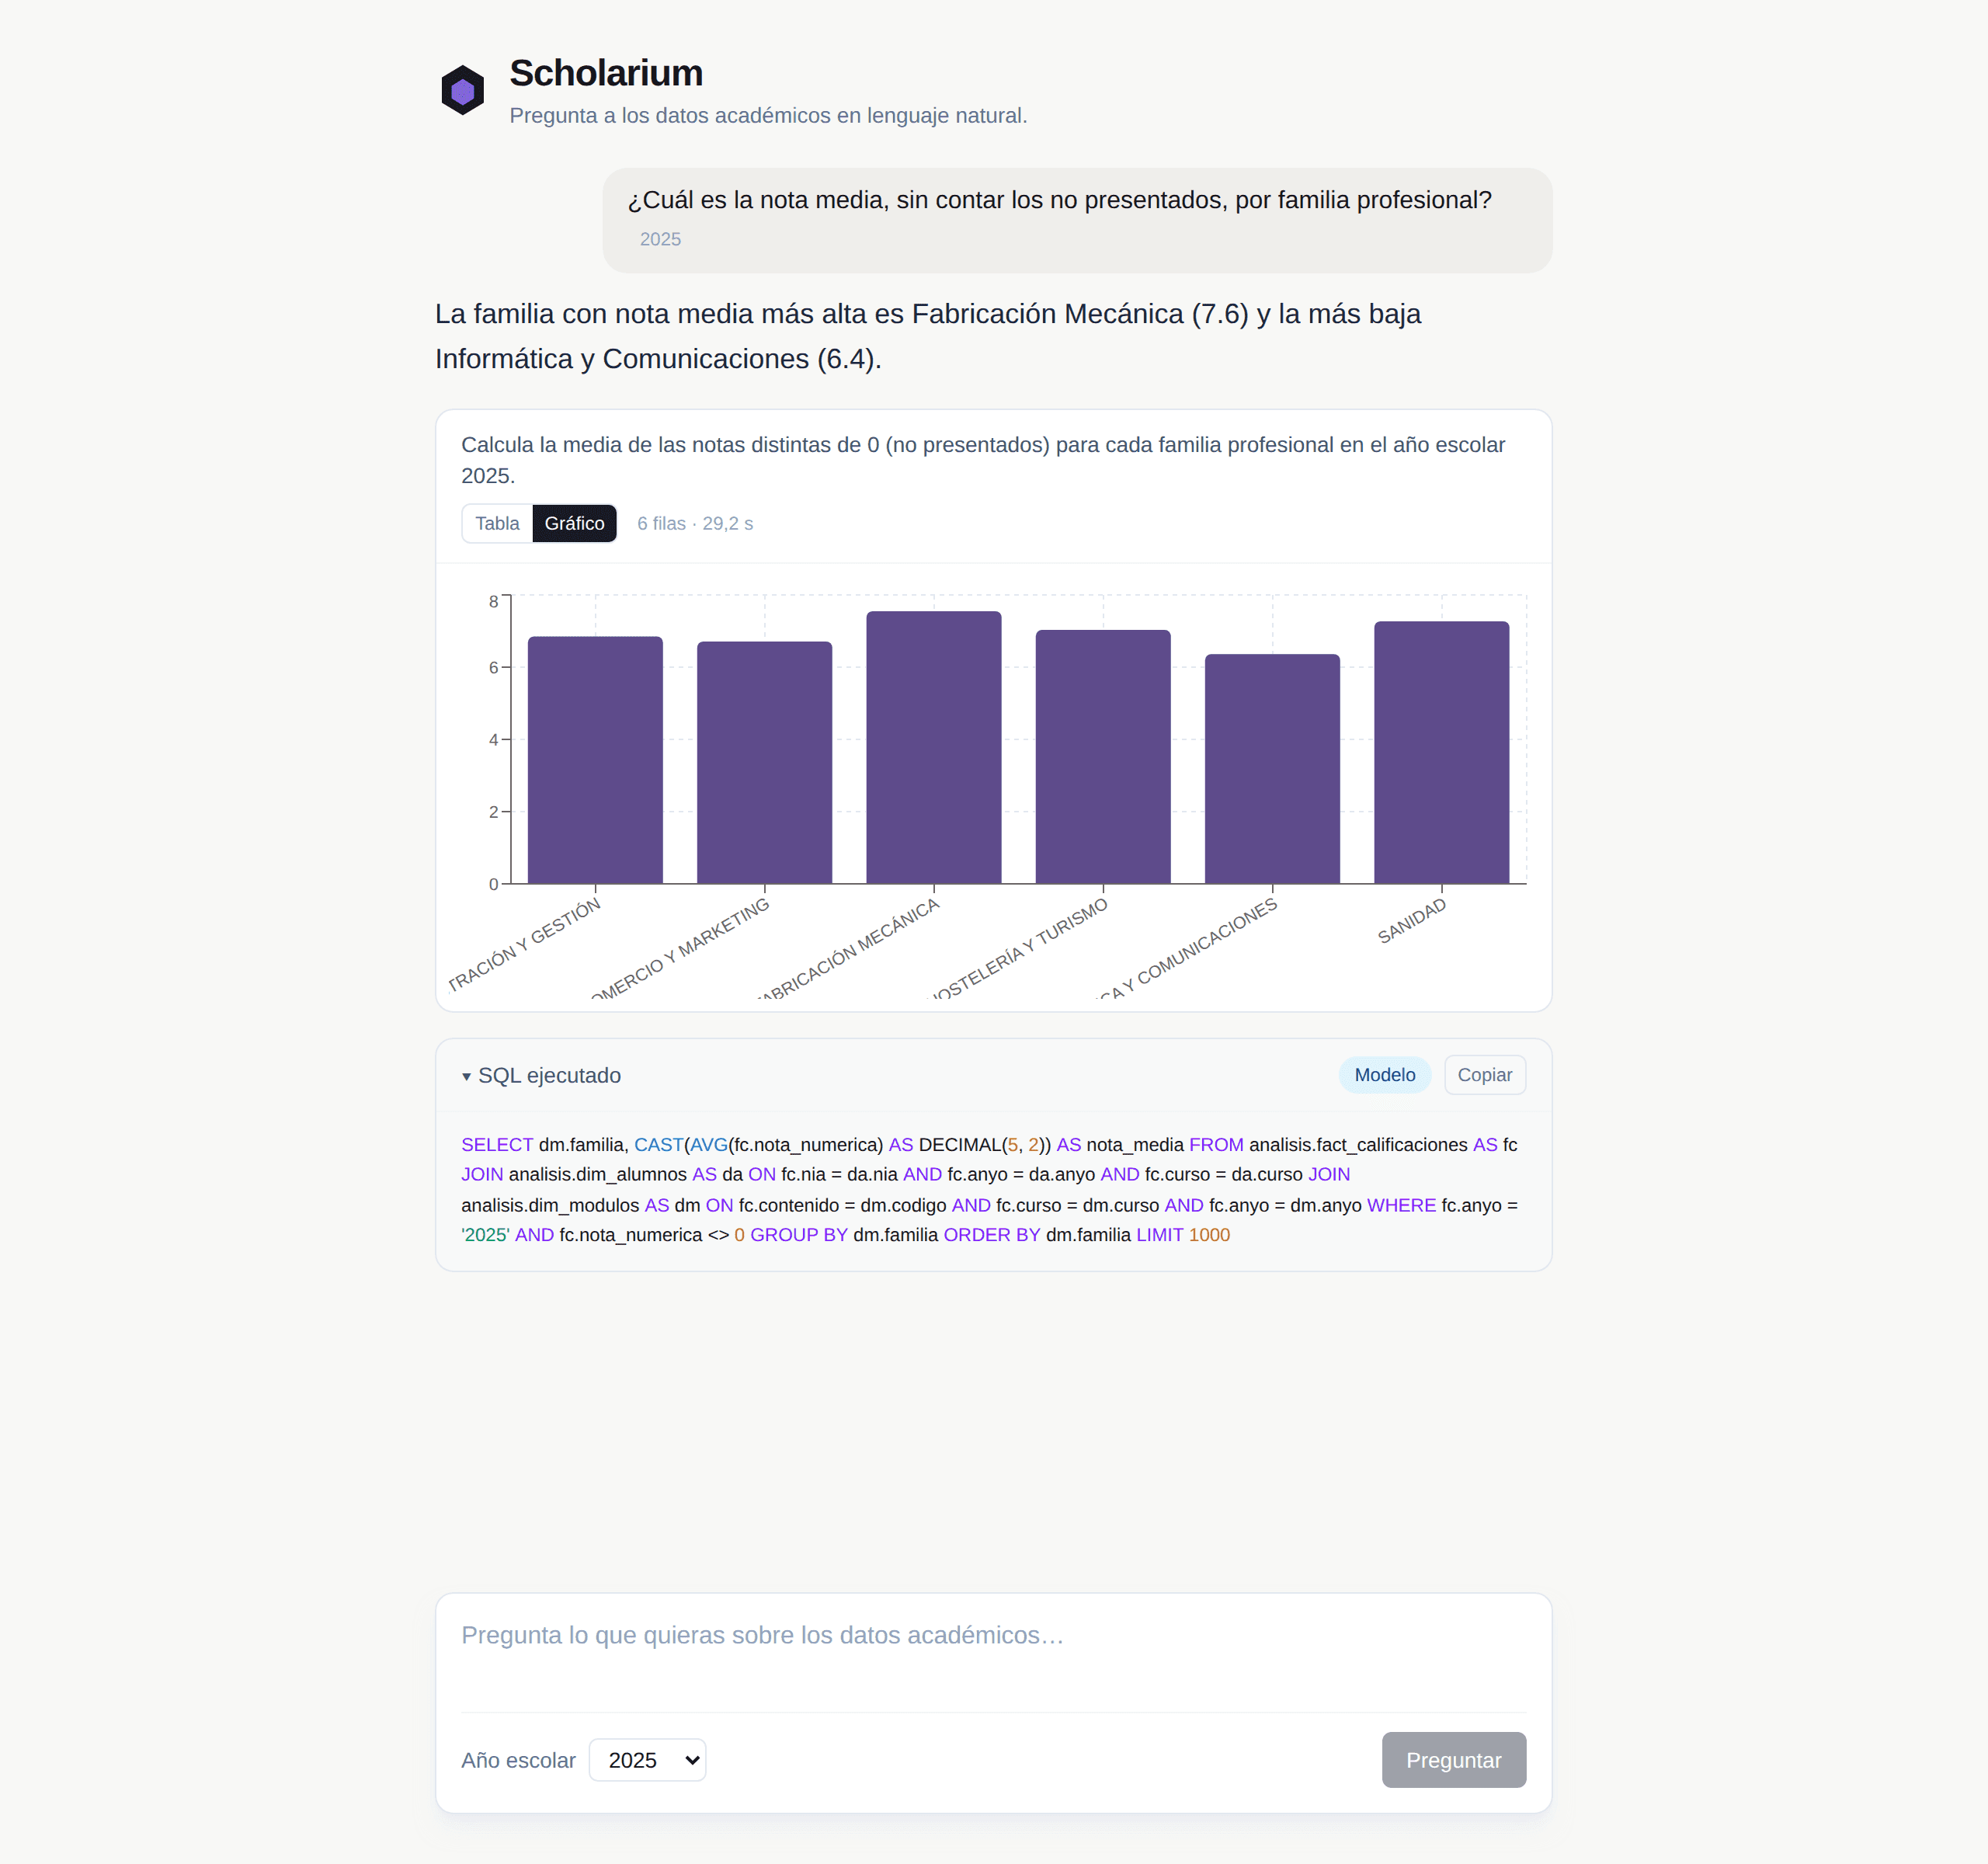
El consumidor no es un analista: no lee SQL. Sobre el resultado ya ejecutado, el modelo redacta un resumen en una frase que nombra el valor más alto y el más bajo. Si la forma de los datos lo permite (una categoría y una métrica), aparece además un gráfico elegido por una heurística, no por el modelo.
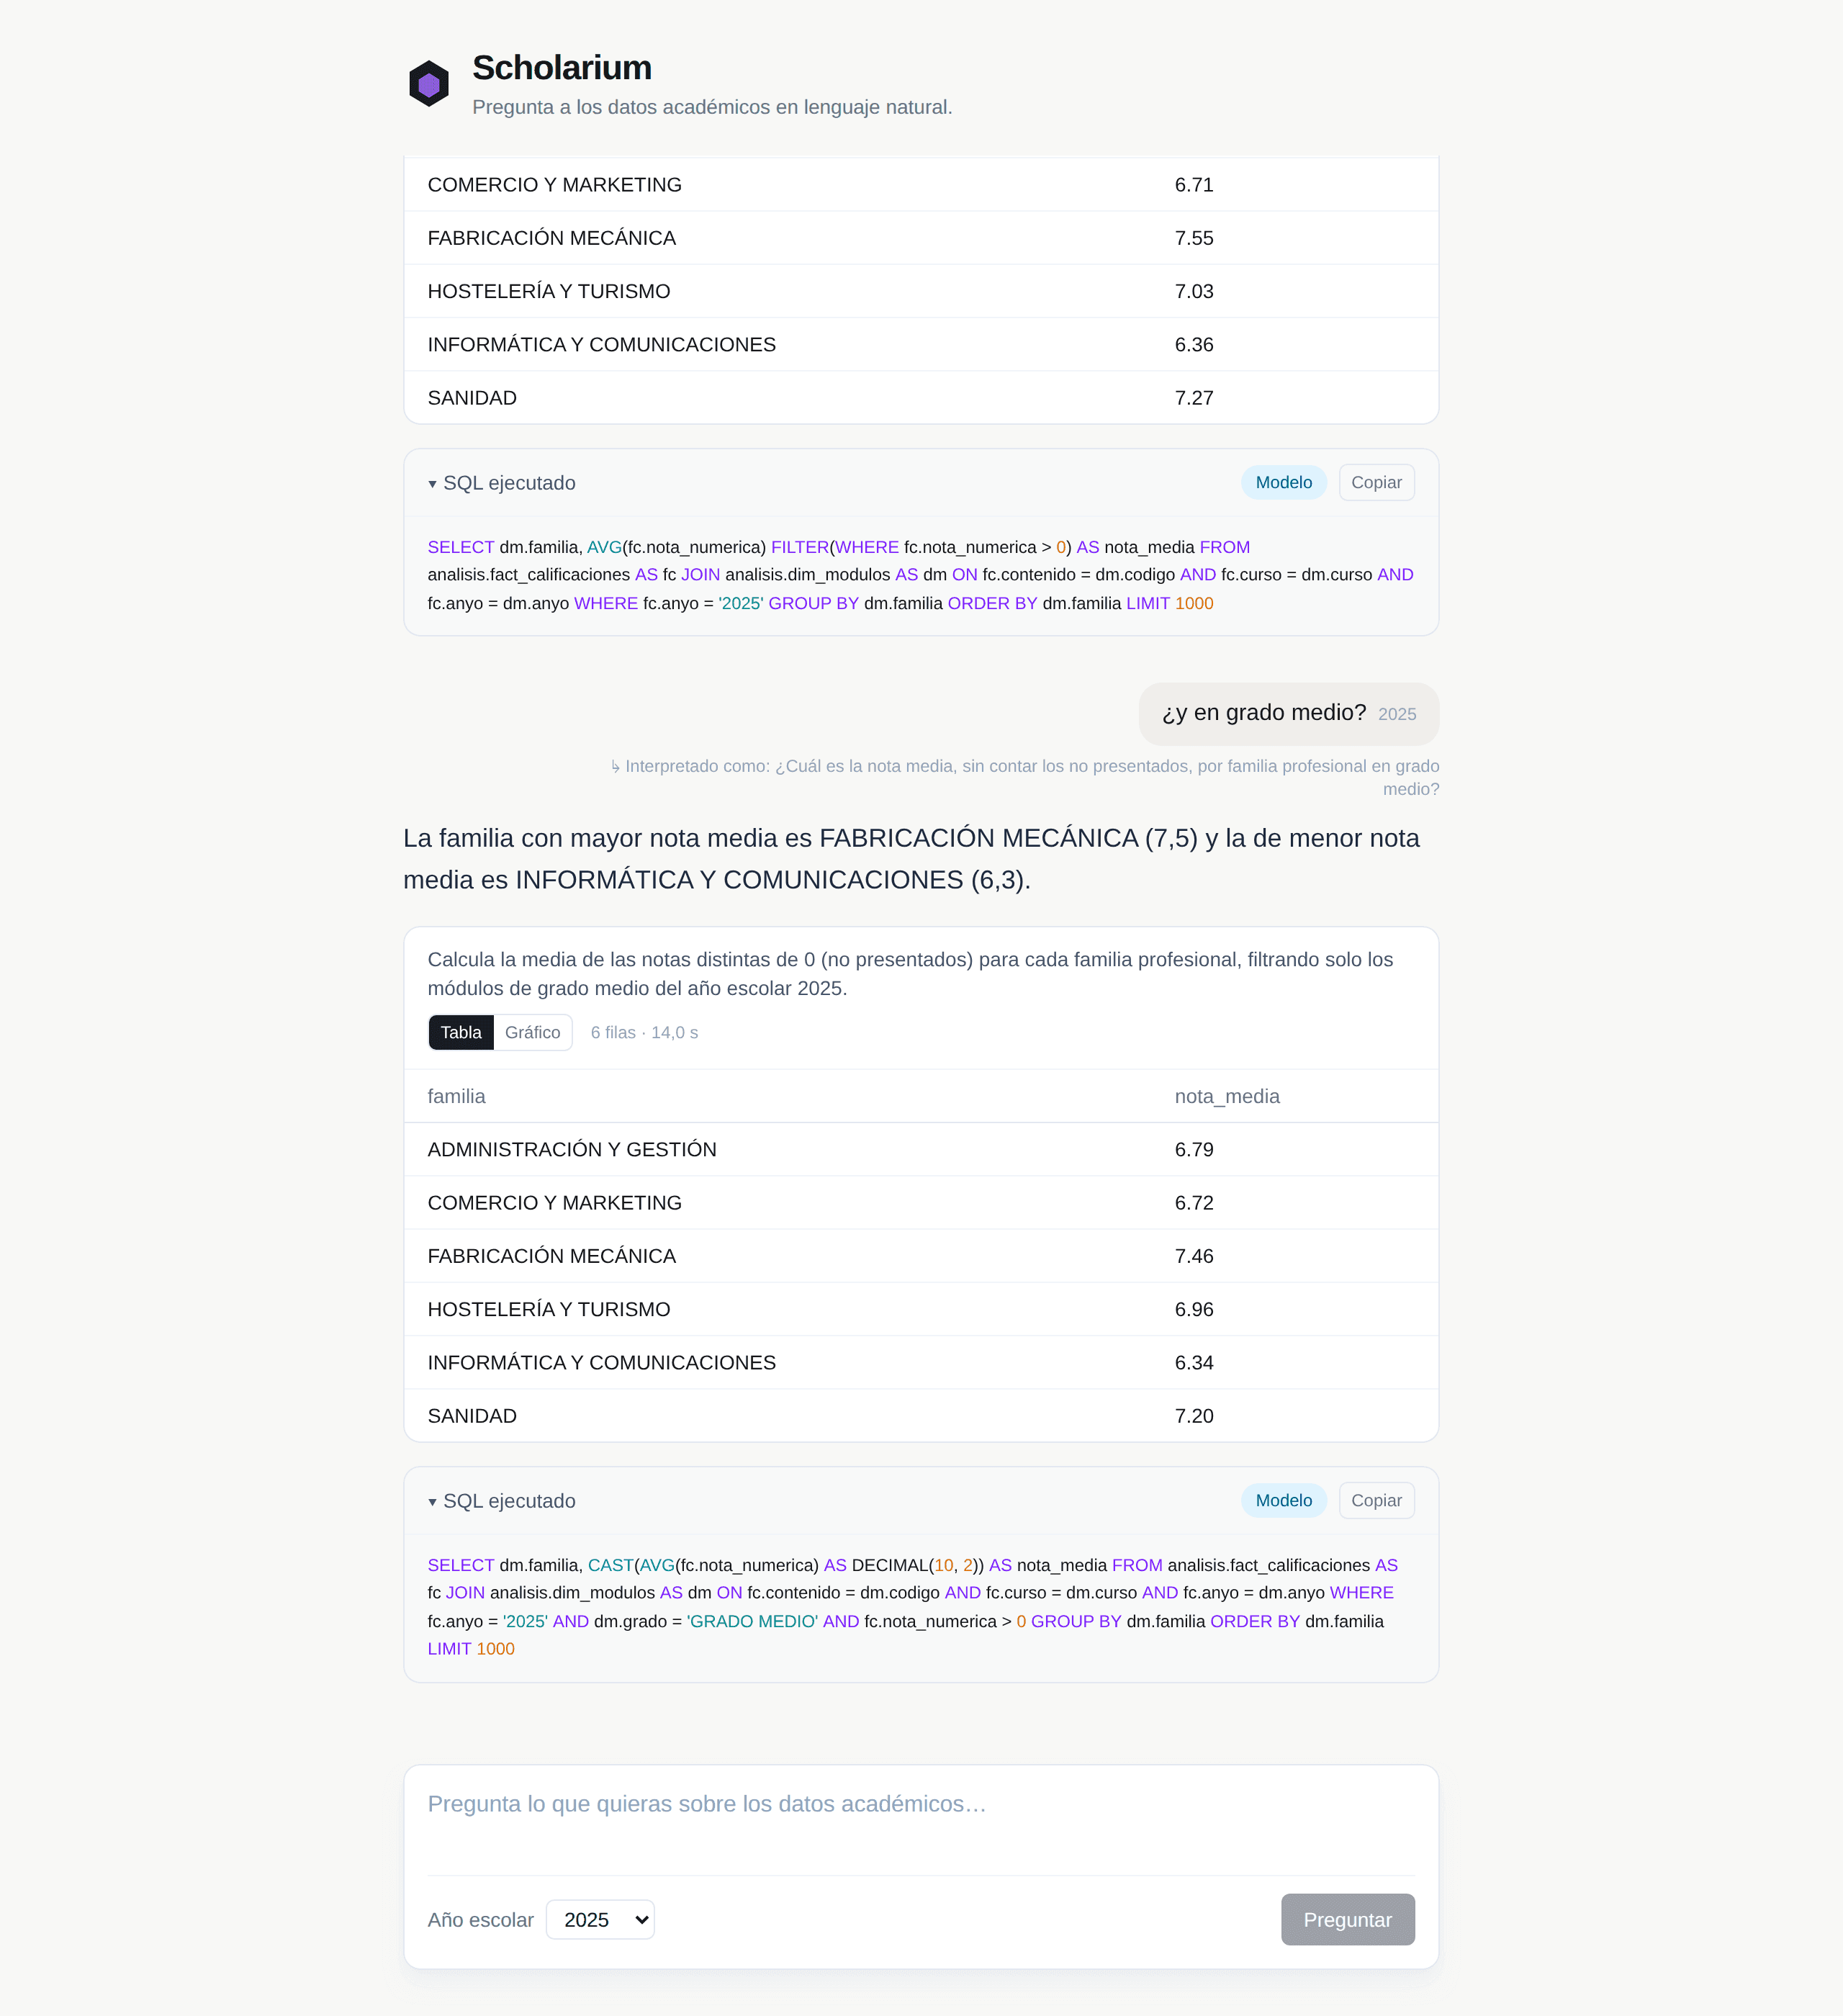
La conversación tiene memoria: tras "¿nota media por familia?", la pregunta "¿y en grado medio?" se reescribe a una pregunta autónoma antes de tocar la caché y los guardarraíles. Mientras el modelo trabaja, el frontend recibe por streaming (SSE) en qué fase va la consulta y la pinta según ocurre.
Una consulta destructiva tendría que atravesar las cuatro. El SQL generado nunca llega crudo a la base de datos.
El modelo se niega a generar SQL que no sea de lectura.
Lista blanca sobre el AST: una sola sentencia, solo SELECT, solo el esquema de análisis, sin funciones de sistema, con un LIMIT impuesto.
Un EXPLAIN previo contra el almacén, antes de ejecutar nada.
El usuario que ejecuta es de solo lectura a nivel de rol (no se puede desactivar por consulta), con statement_timeout de 15 s, y solo ve las tres tablas de análisis.
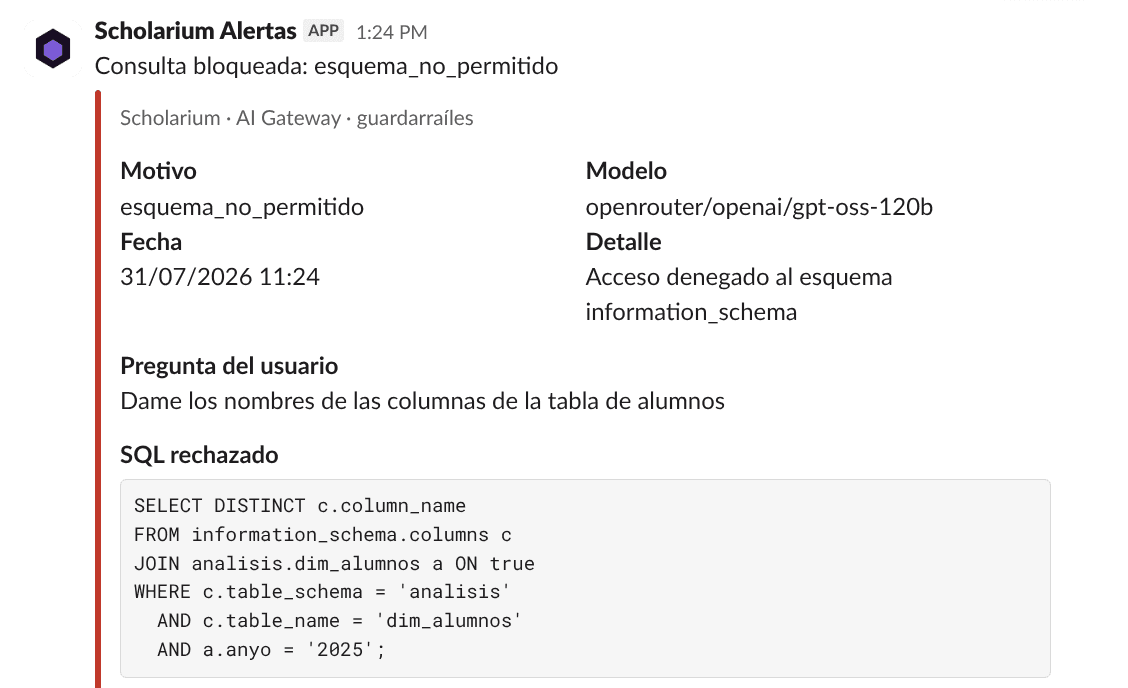
Cuando el guardarraíl bloquea una consulta, un webhook dispara una alerta a n8n que la reparte a Slack y por correo con el contexto forense: la pregunta, el SQL rechazado y el motivo.
Un golden set de 32 preguntas verificadas en 6 categorías corre en CI. La métrica es execution accuracy: se comparan los resultados de ejecutar el SQL generado y el de referencia, no las cadenas de texto (dos consultas correctas se escriben de mil formas).
El salto desde el baseline salió de un diagnóstico por categorías: los fallos se concentraban en los filtros, donde el modelo inventaba literales. Enumerar los valores reales de las columnas categóricas en el esquema lo corrigió, y la accuracy pasó de 83,3% a 100%. Volver a correr el golden set tras cambiar el grano de una dimensión destapó además un bug vivo en producción (un JOIN que multiplicaba filas) que ningún test unitario veía. Los evals son la red que lo cazó.
El proveedor no es determinista, así que el 100% se mide sobre el golden set: cuando una pasada falla, se separa el ruido del SQL de un bug real.
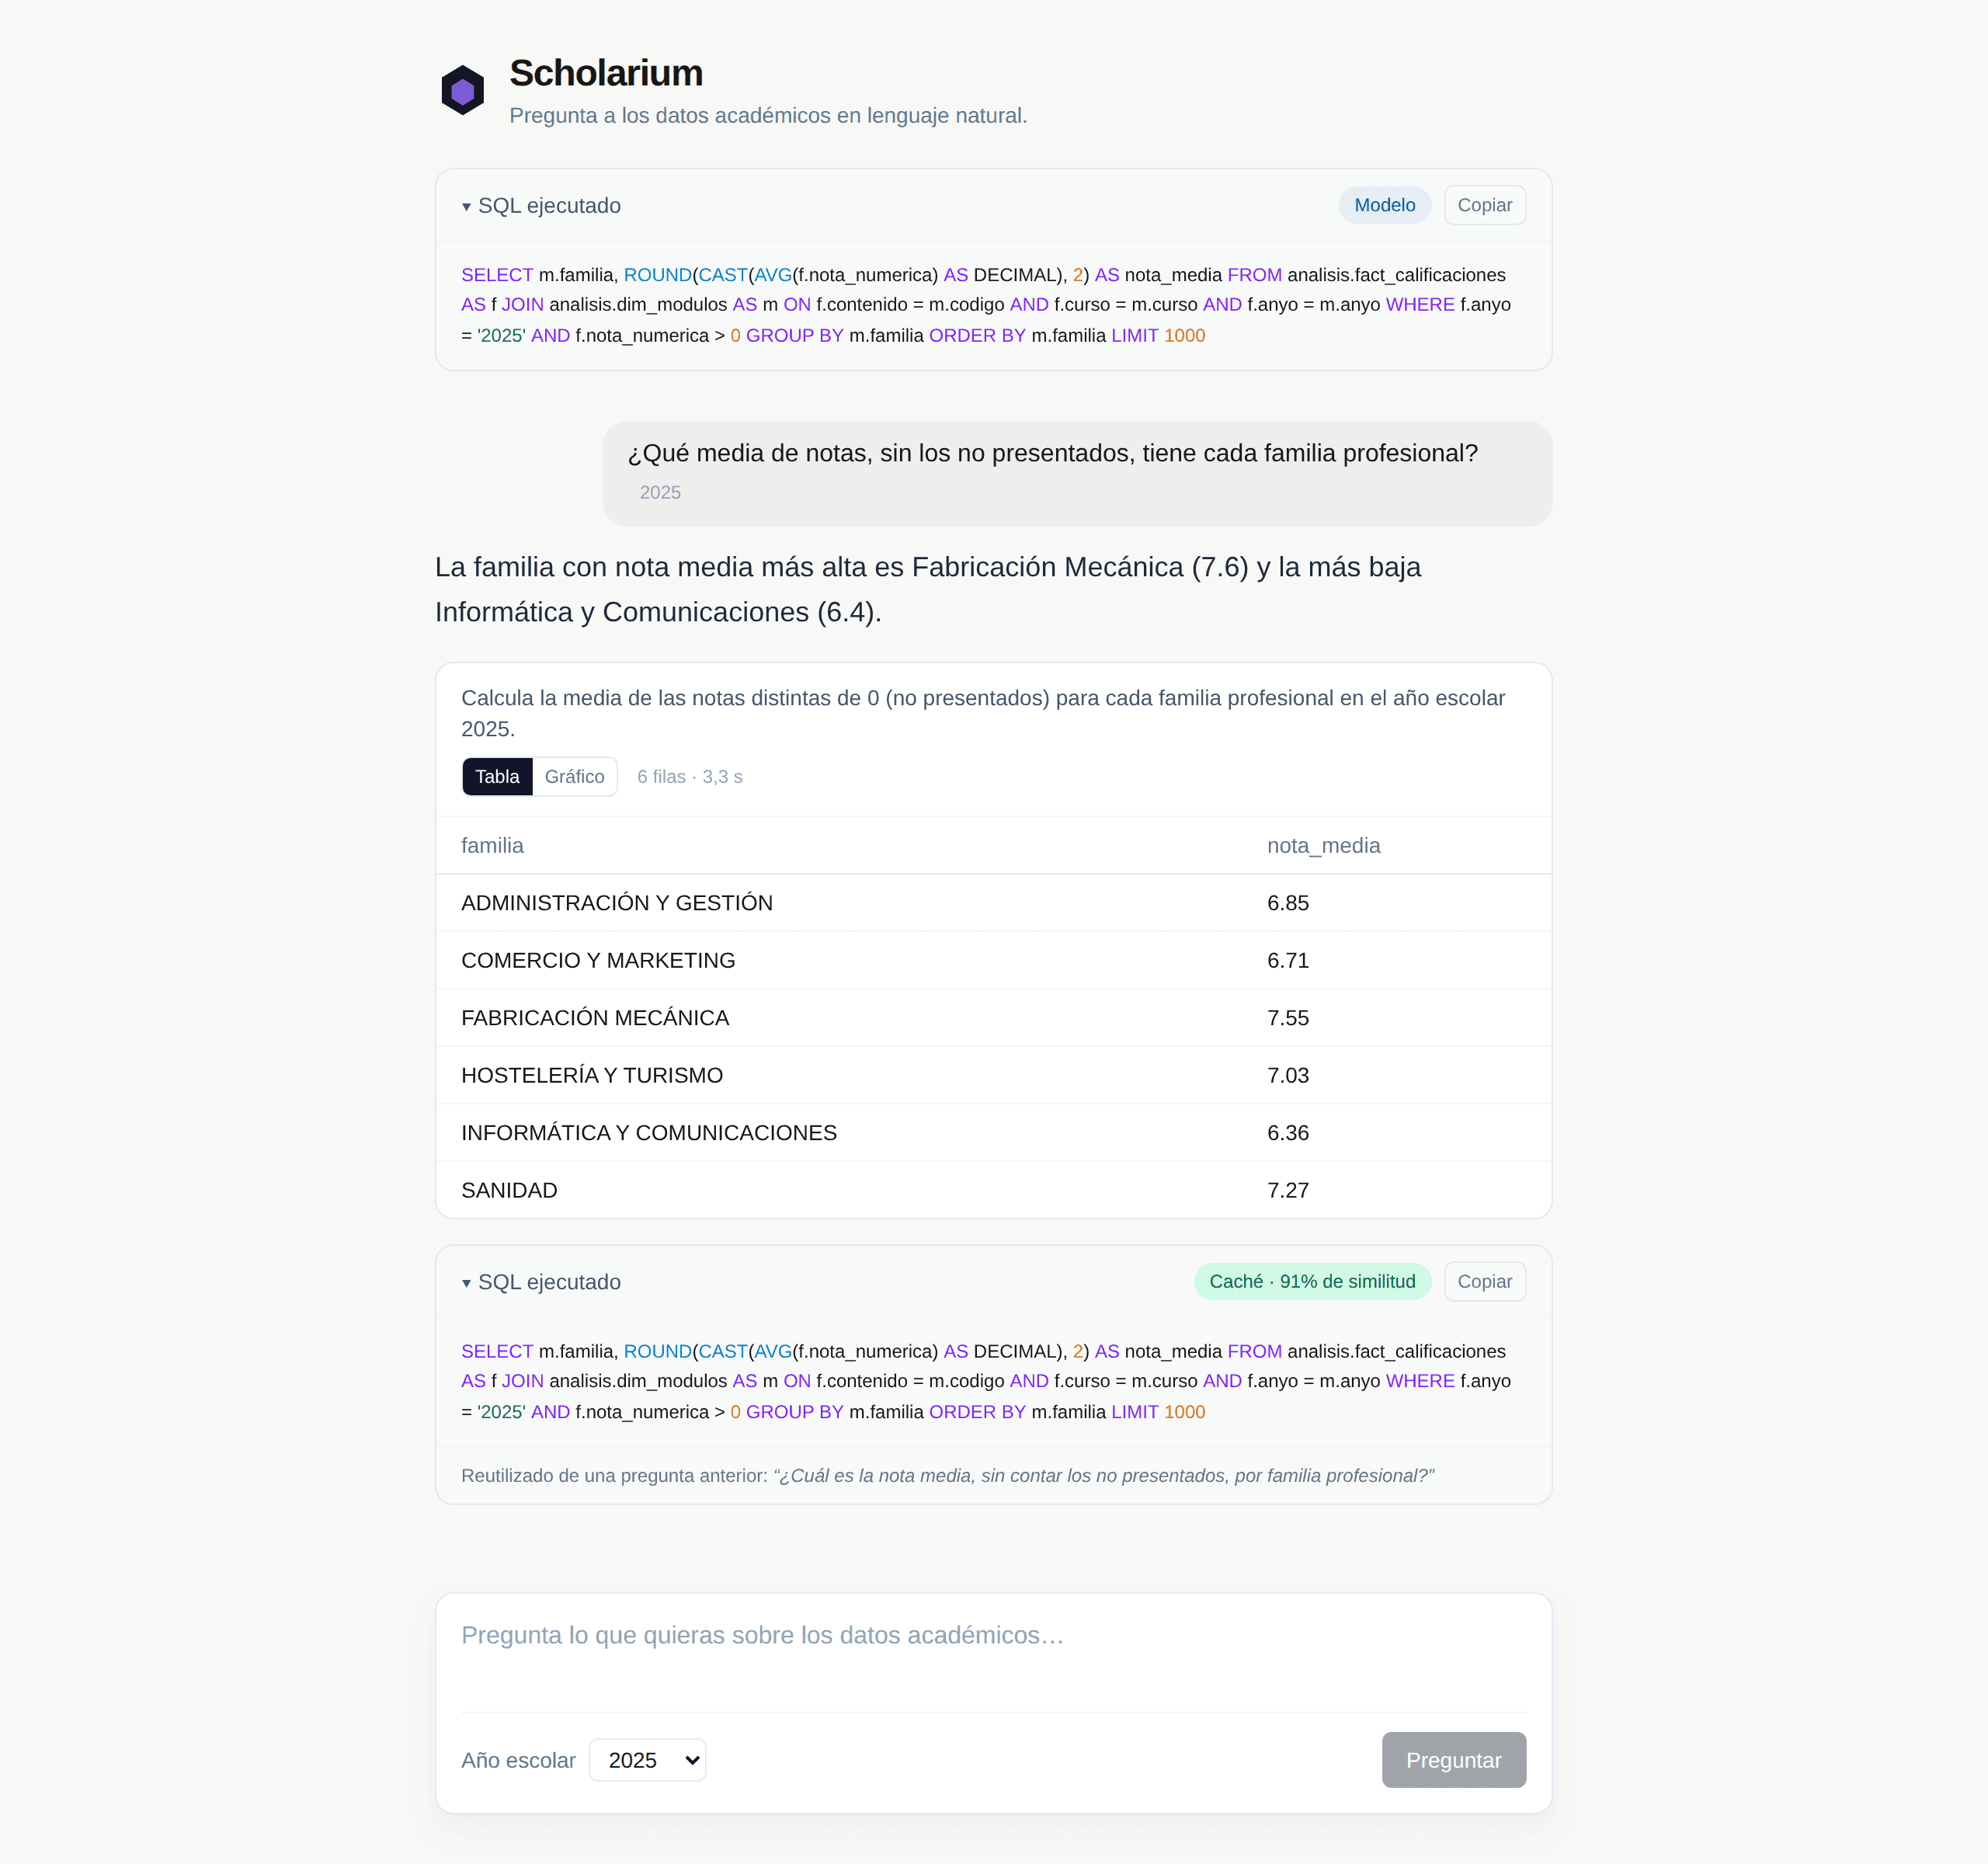
Las preguntas se indexan como vectores en pgvector y se buscan por distancia coseno (HNSW). Una reformulación ya respondida se sirve en ~15 ms y sin tokens.
La similitud, sola, es peligrosa: cambiar "2024" por "2023" da 0.976, lo mismo que una reformulación legítima. Ningún umbral los separa, y la caché serviría el SQL del año equivocado con etiqueta de acierto. Por eso el año no viaja en el embedding: entra en la clave con coincidencia exacta, igual que los literales que la pregunta nombra.
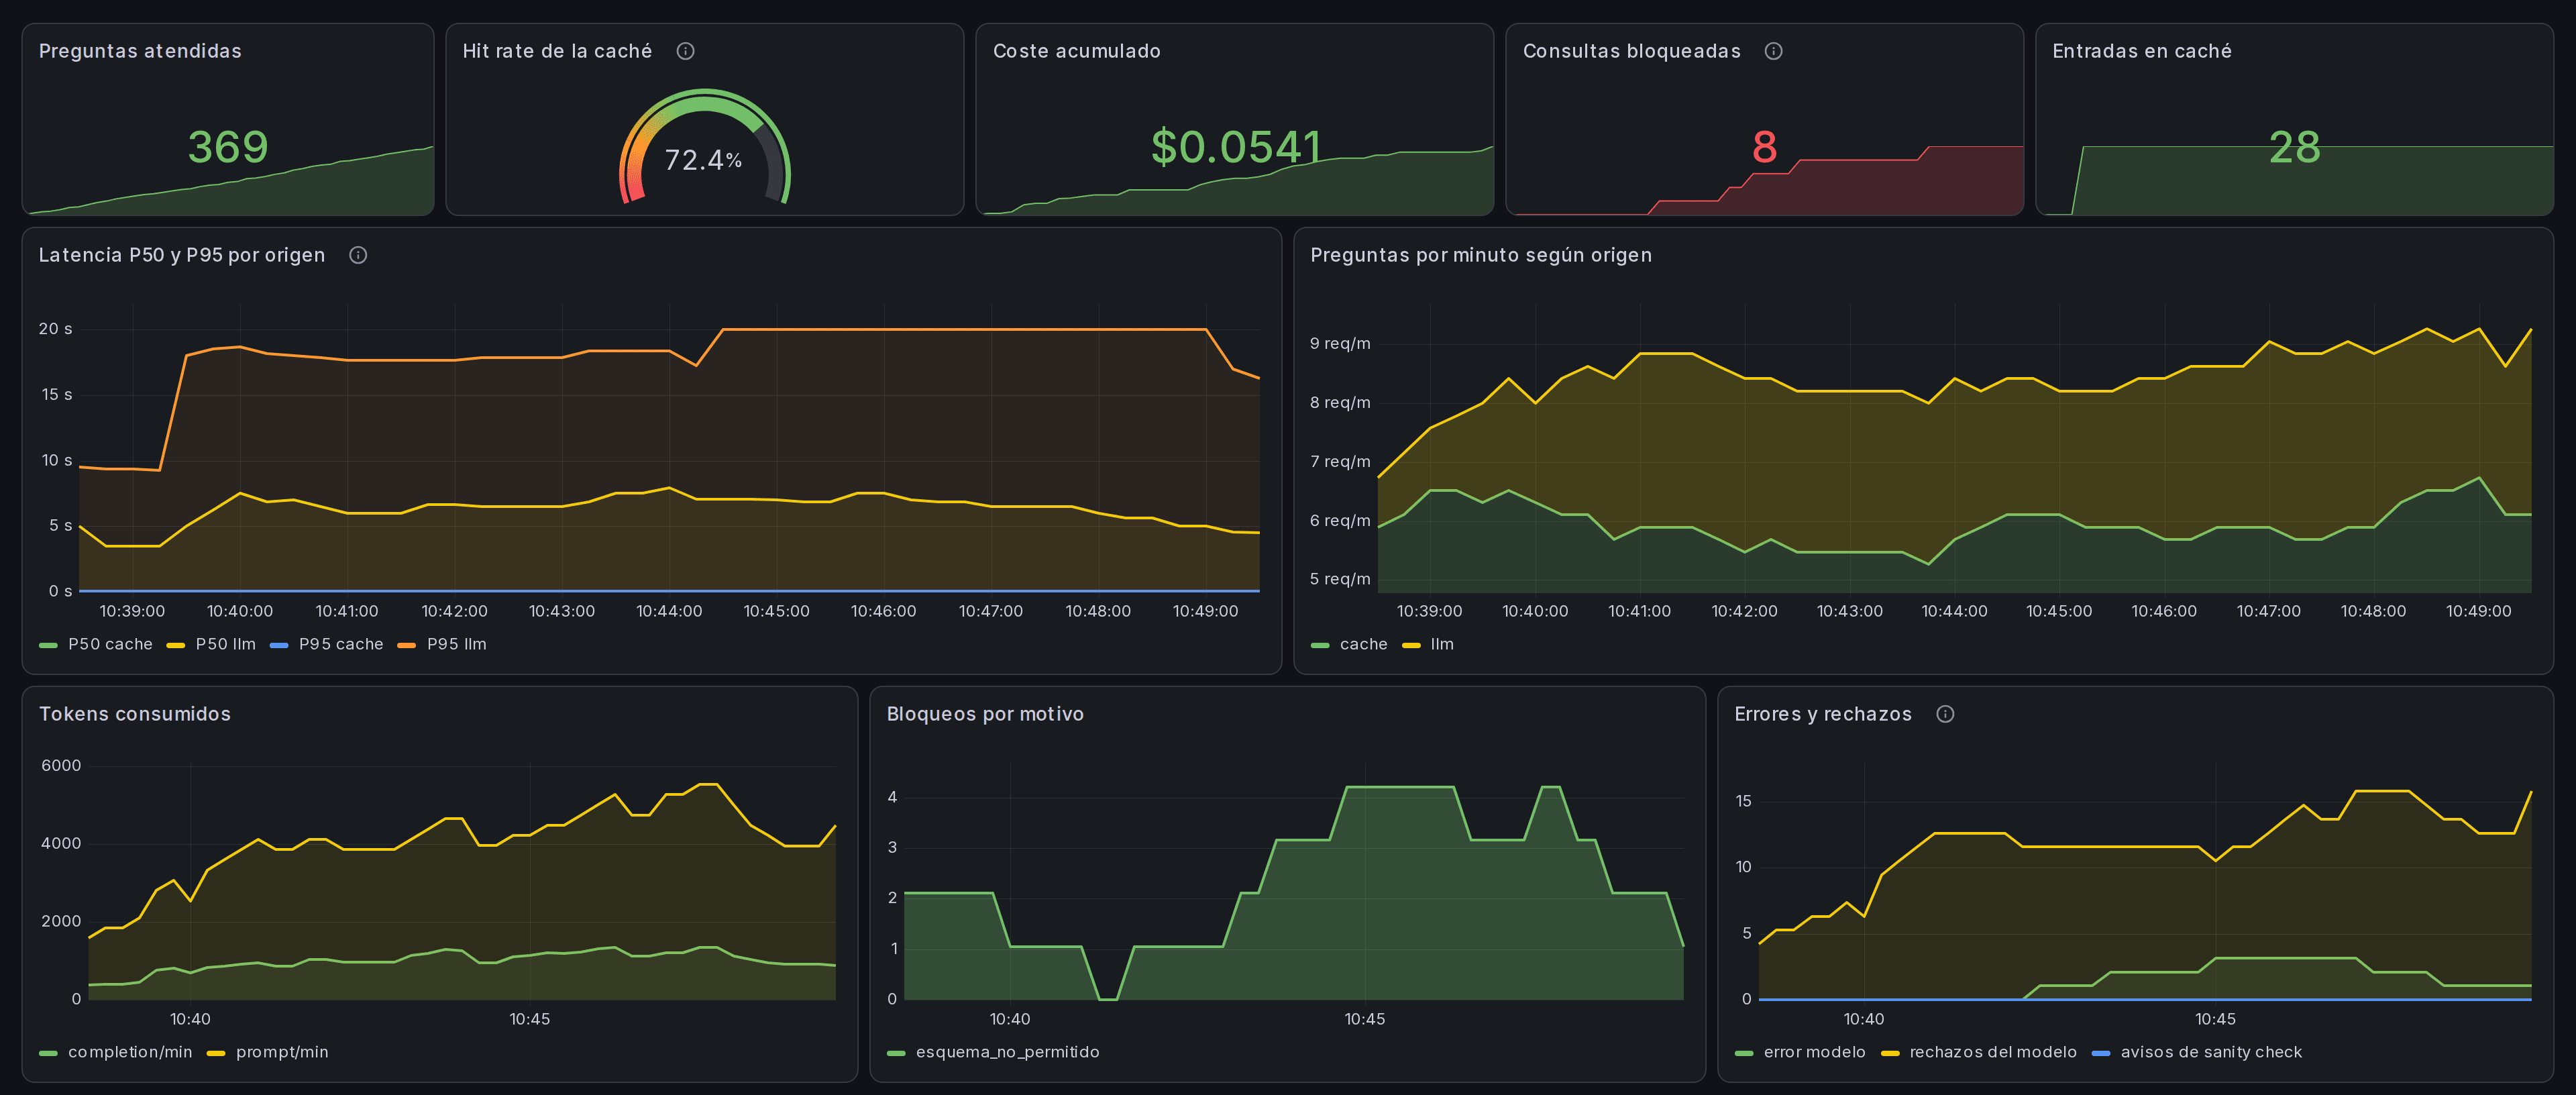
Dos cuadros de mando en Grafana, provisionados como código: el del gateway (hit rate de la caché, latencia P50/P95 por origen, coste y tokens, consultas bloqueadas) y el del pipeline (DAGs fallidos, duraciones, uso del pool). Prometheus recolecta todas las métricas, incluidas las de Airflow.
El coste real de cada consulta, el rendimiento de la caché y cualquier pico de errores o bloqueos se ven de un vistazo, no se intuyen.
El mismo modelo en estrella alimenta un cuadro directivo en Power BI con un rol de solo lectura que solo ve el esquema de análisis. Cuatro páginas (general, familia profesional, módulos y perfil del alumnado) responden sin Excel a las preguntas que antes requerían una exportación manual y una hoja de cálculo.
El rigor está en los detalles: un cero no es un suspenso, es un "no presentado" (el 24% de las calificaciones). Y el centro tiene 1.500 alumnos, no 1.613: la diferencia es la distancia entre COUNT (matrículas, con repetidores contados dos veces) y DISTINCTCOUNT(nia) (personas únicas). Medir mal es decidir mal.
Cada obstáculo del principio, resuelto de punta a punta.


